数据流节点
概述
数据流节点用于通过算子完成数据读取、处理和输出。本文说明如何创建数据流节点、预览节点数据、分析字段血缘,并列出各类算子文档。
创建数据流节点
进入离线开发任务编辑页面后,从左侧面板将「数据流」节点拖入画布。选中节点后,点击「编辑」进入算子编辑页面。

预览节点数据
在算子编辑页面中选中需要检查的节点,点击「预览」。
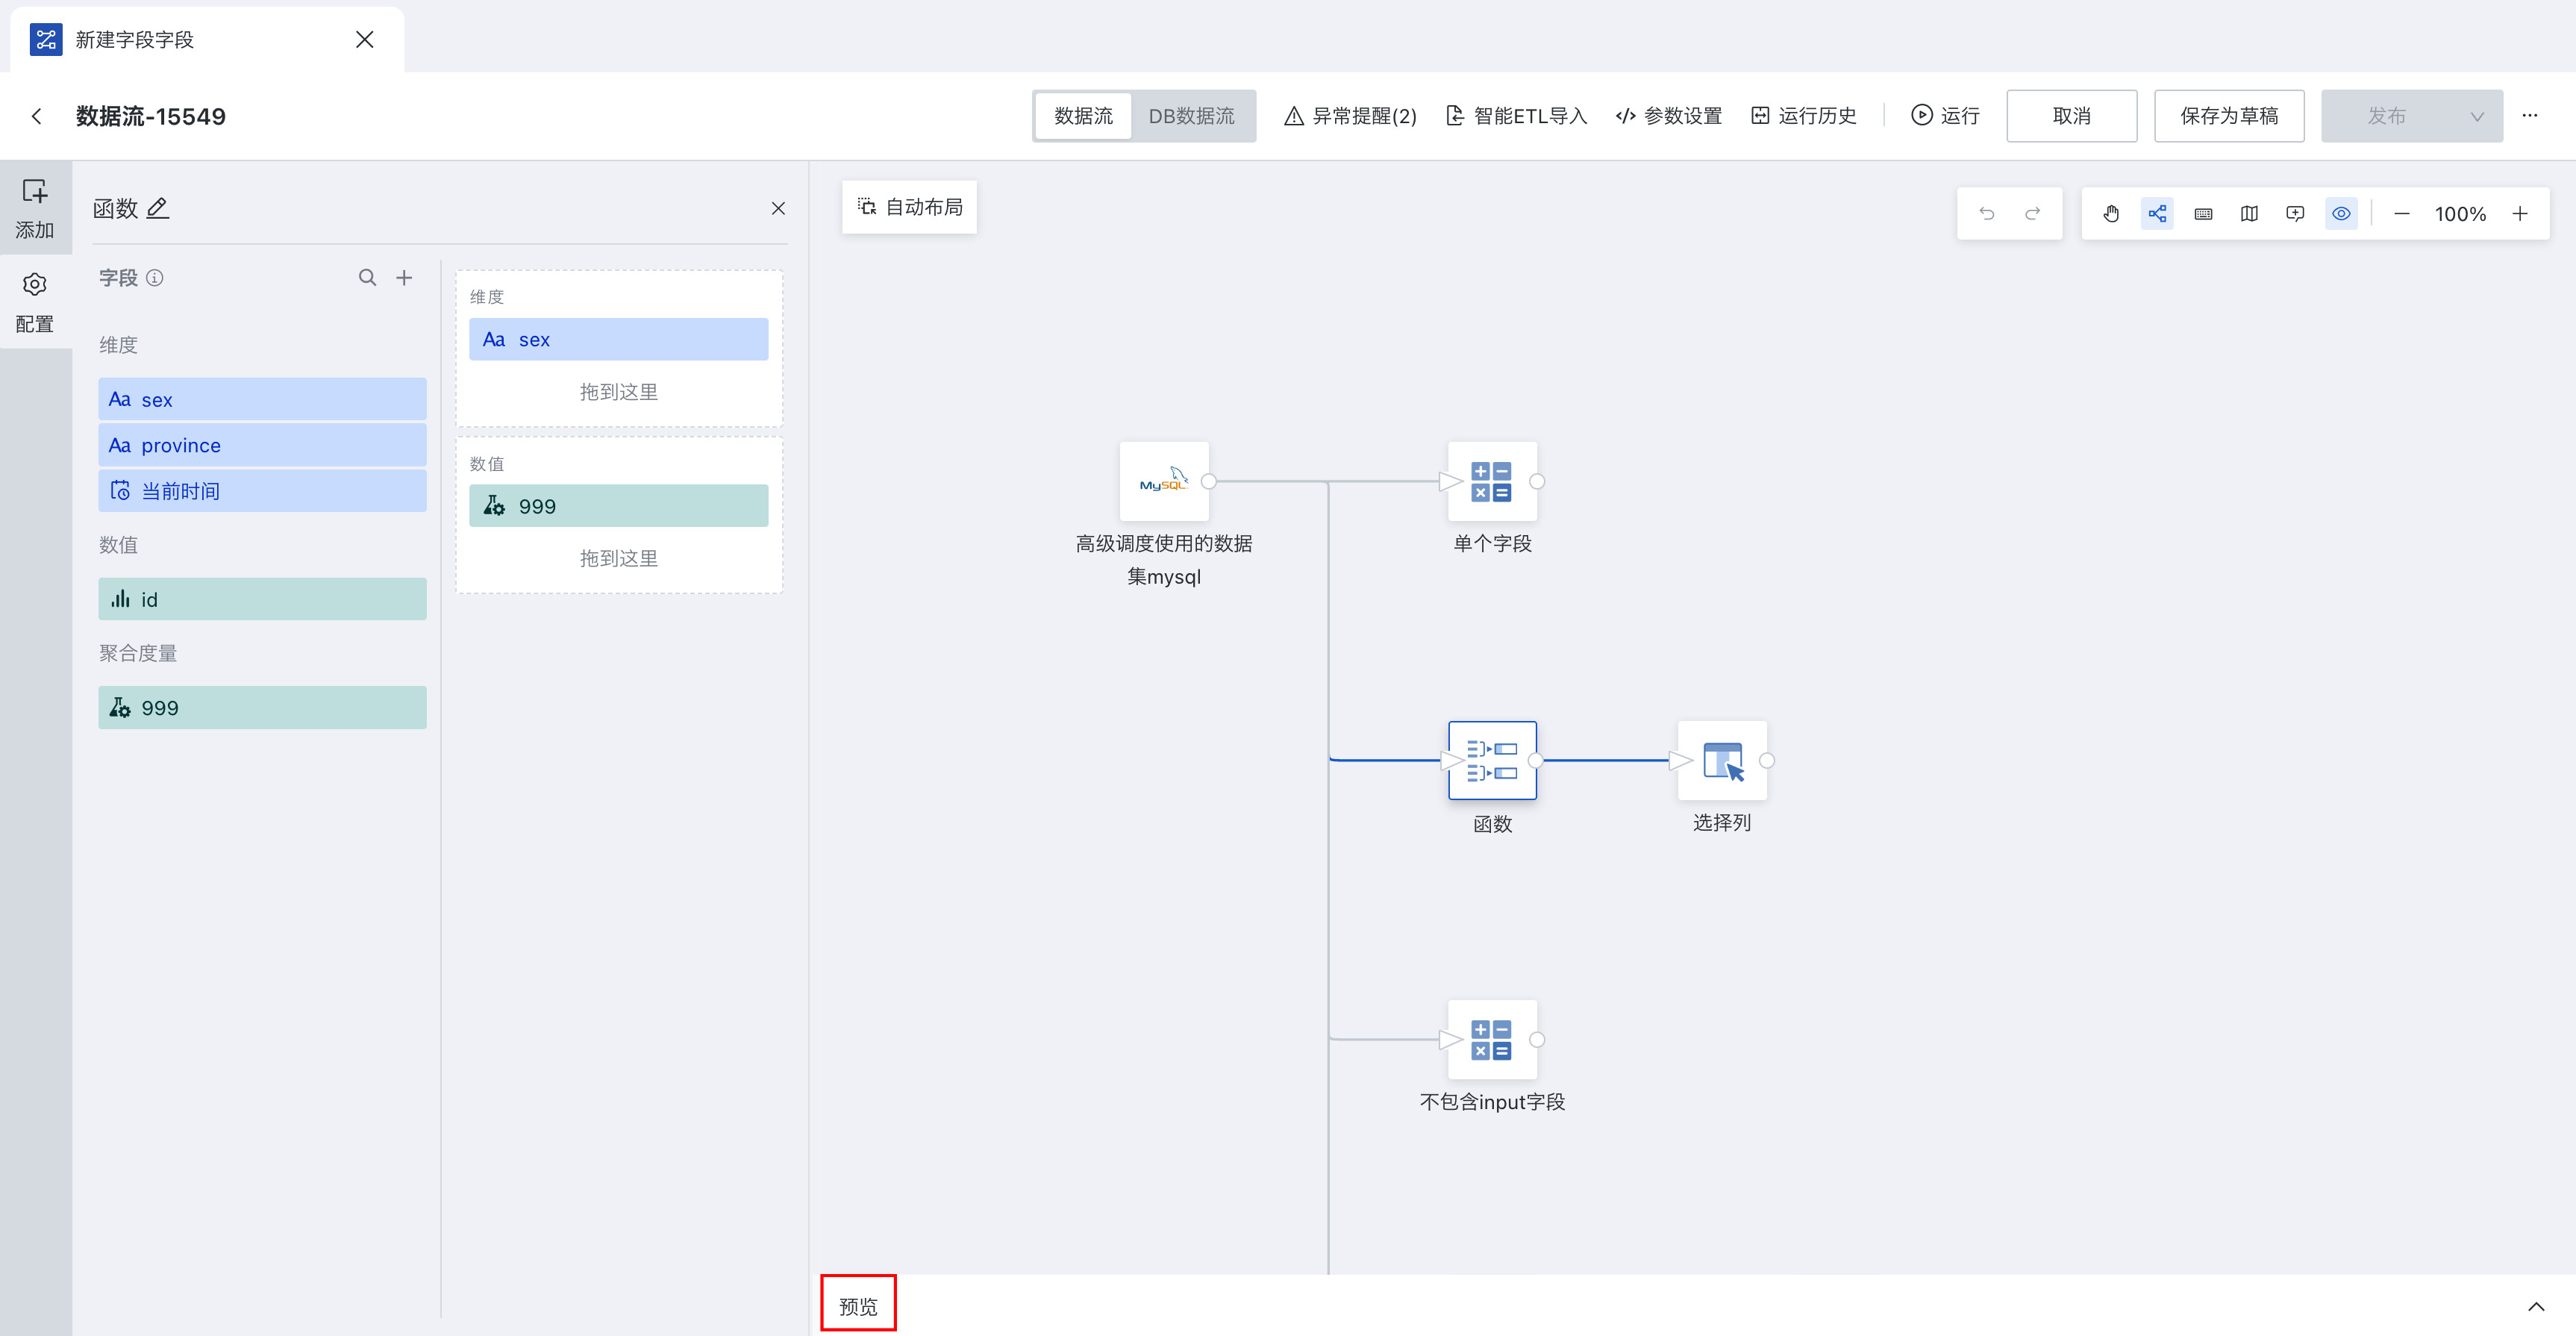
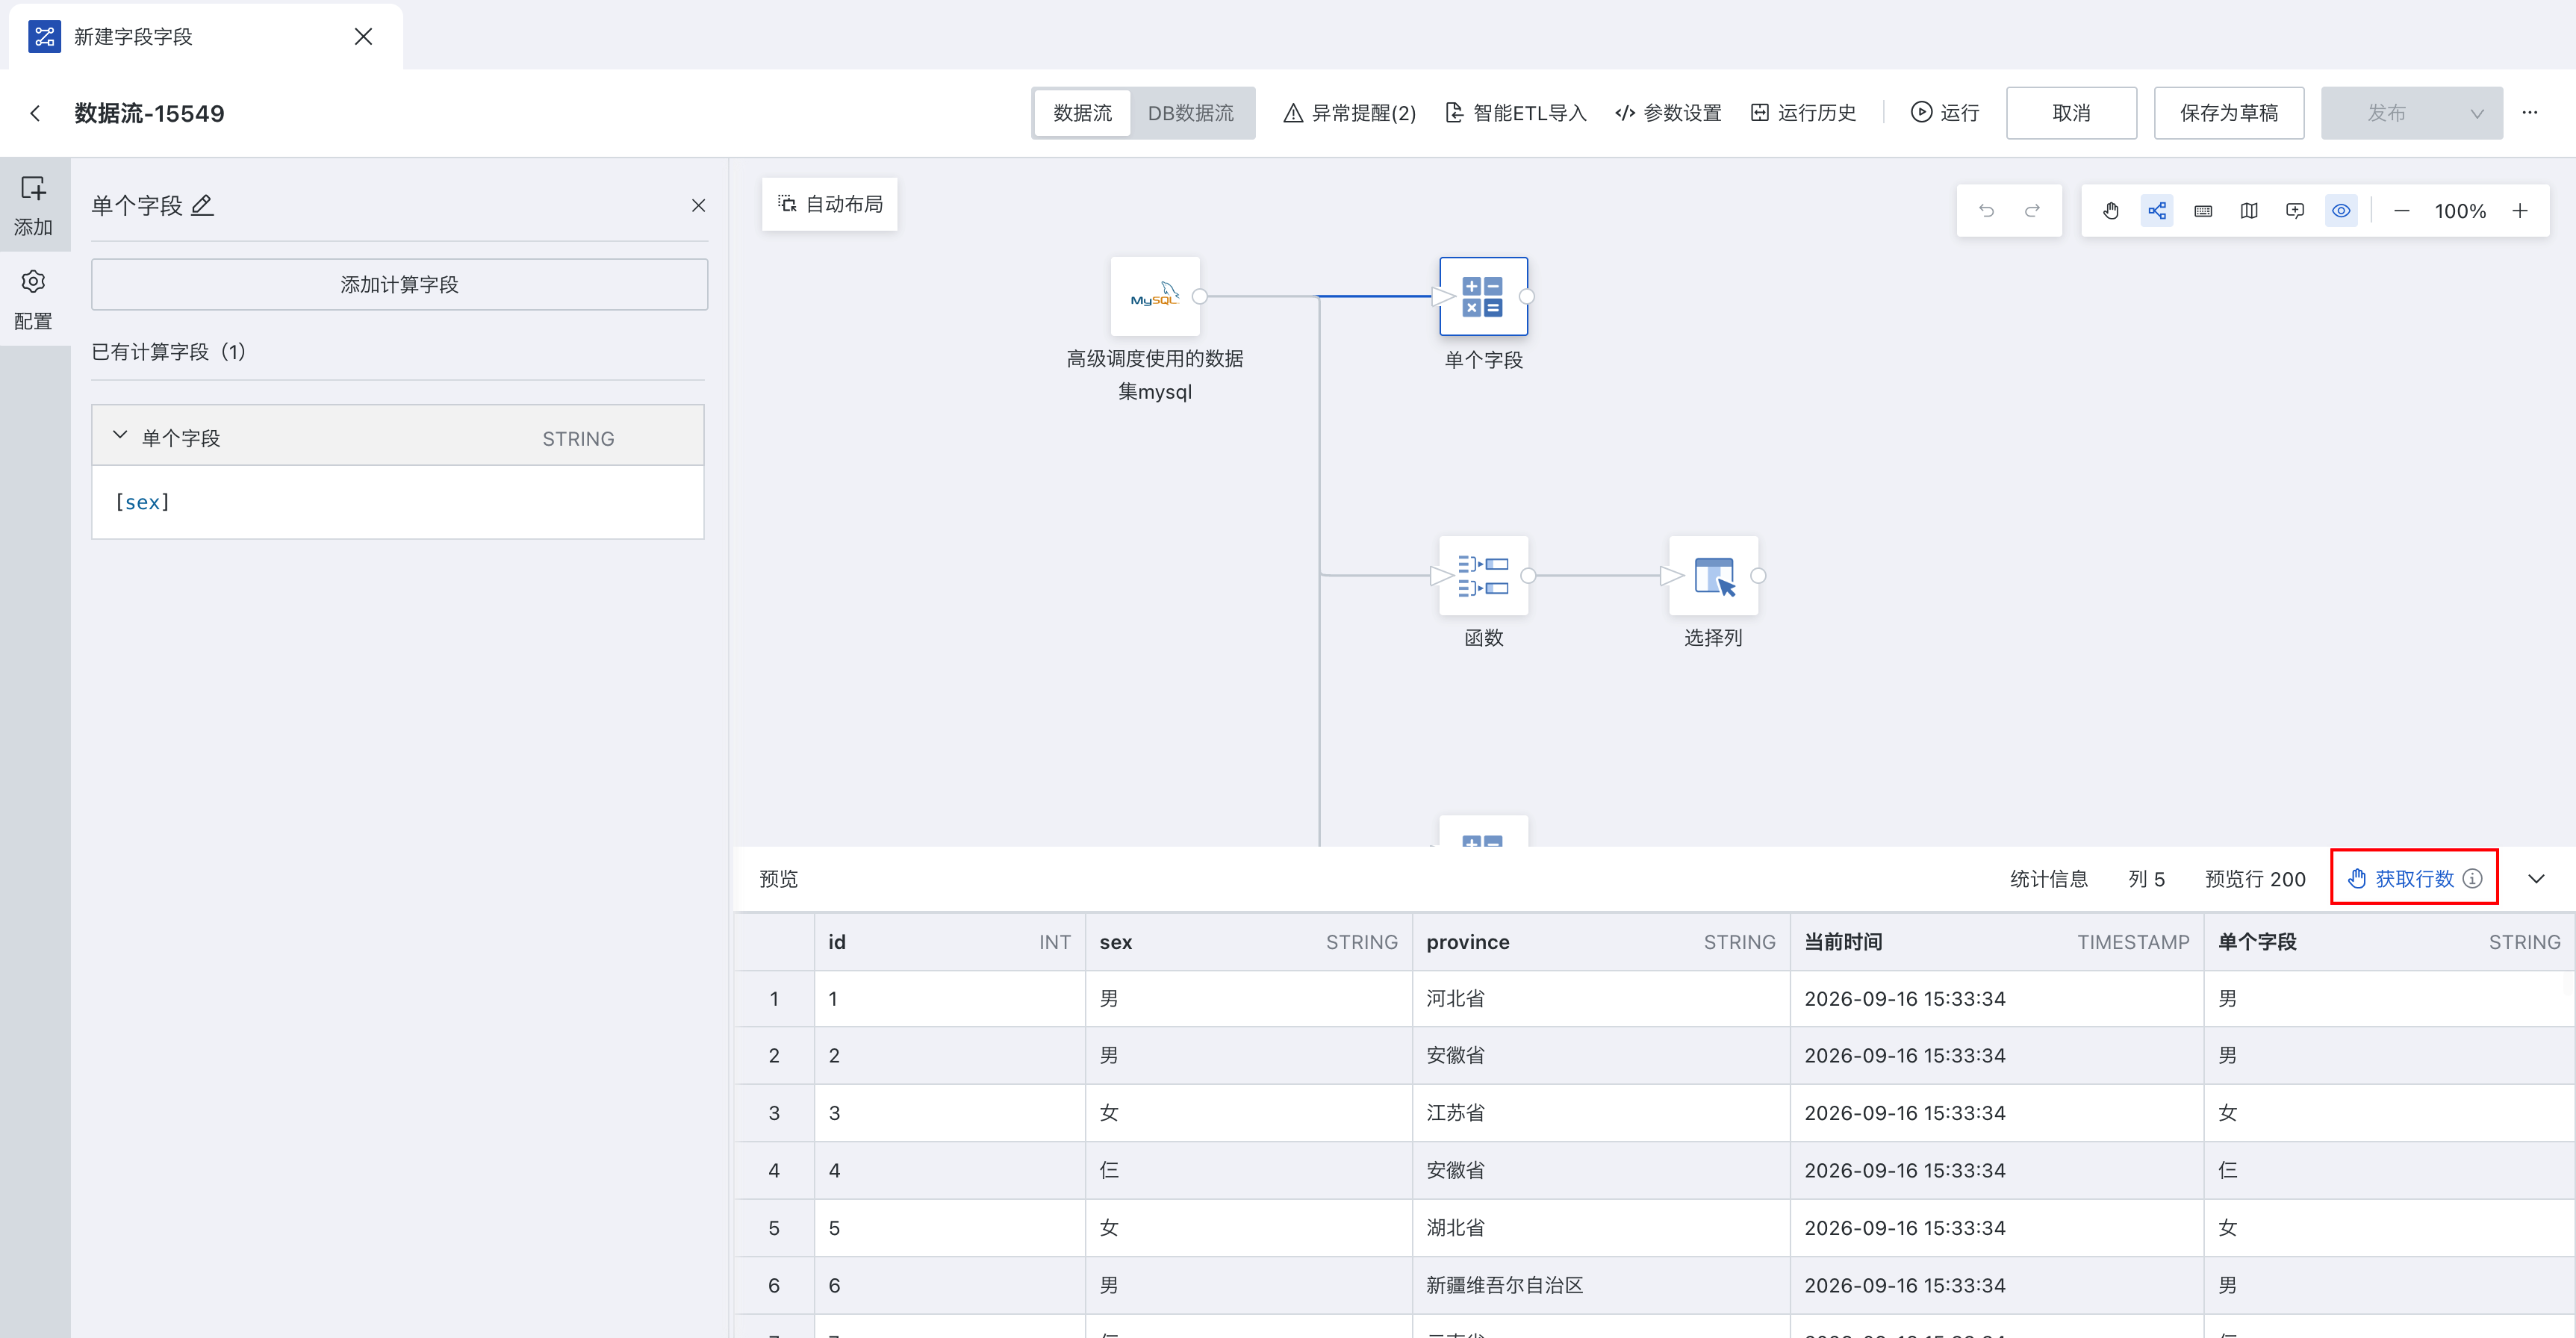
系统执行该节点及其上游处理逻辑,并在预览结果区展示当前节点的输出字段、部分数据和预览行数。可以通过预览结果检查节点配置、字段及数据内容是否符合预期。
如需确认当前节点处理结果的总行数,点击「获取行数」。计算完成后,原位置会显示「全量行数」及具体数值。该功能可用于核对筛选、去重、聚合等处理前后的数据量变化,不会将全部数据加载到预览表格中。
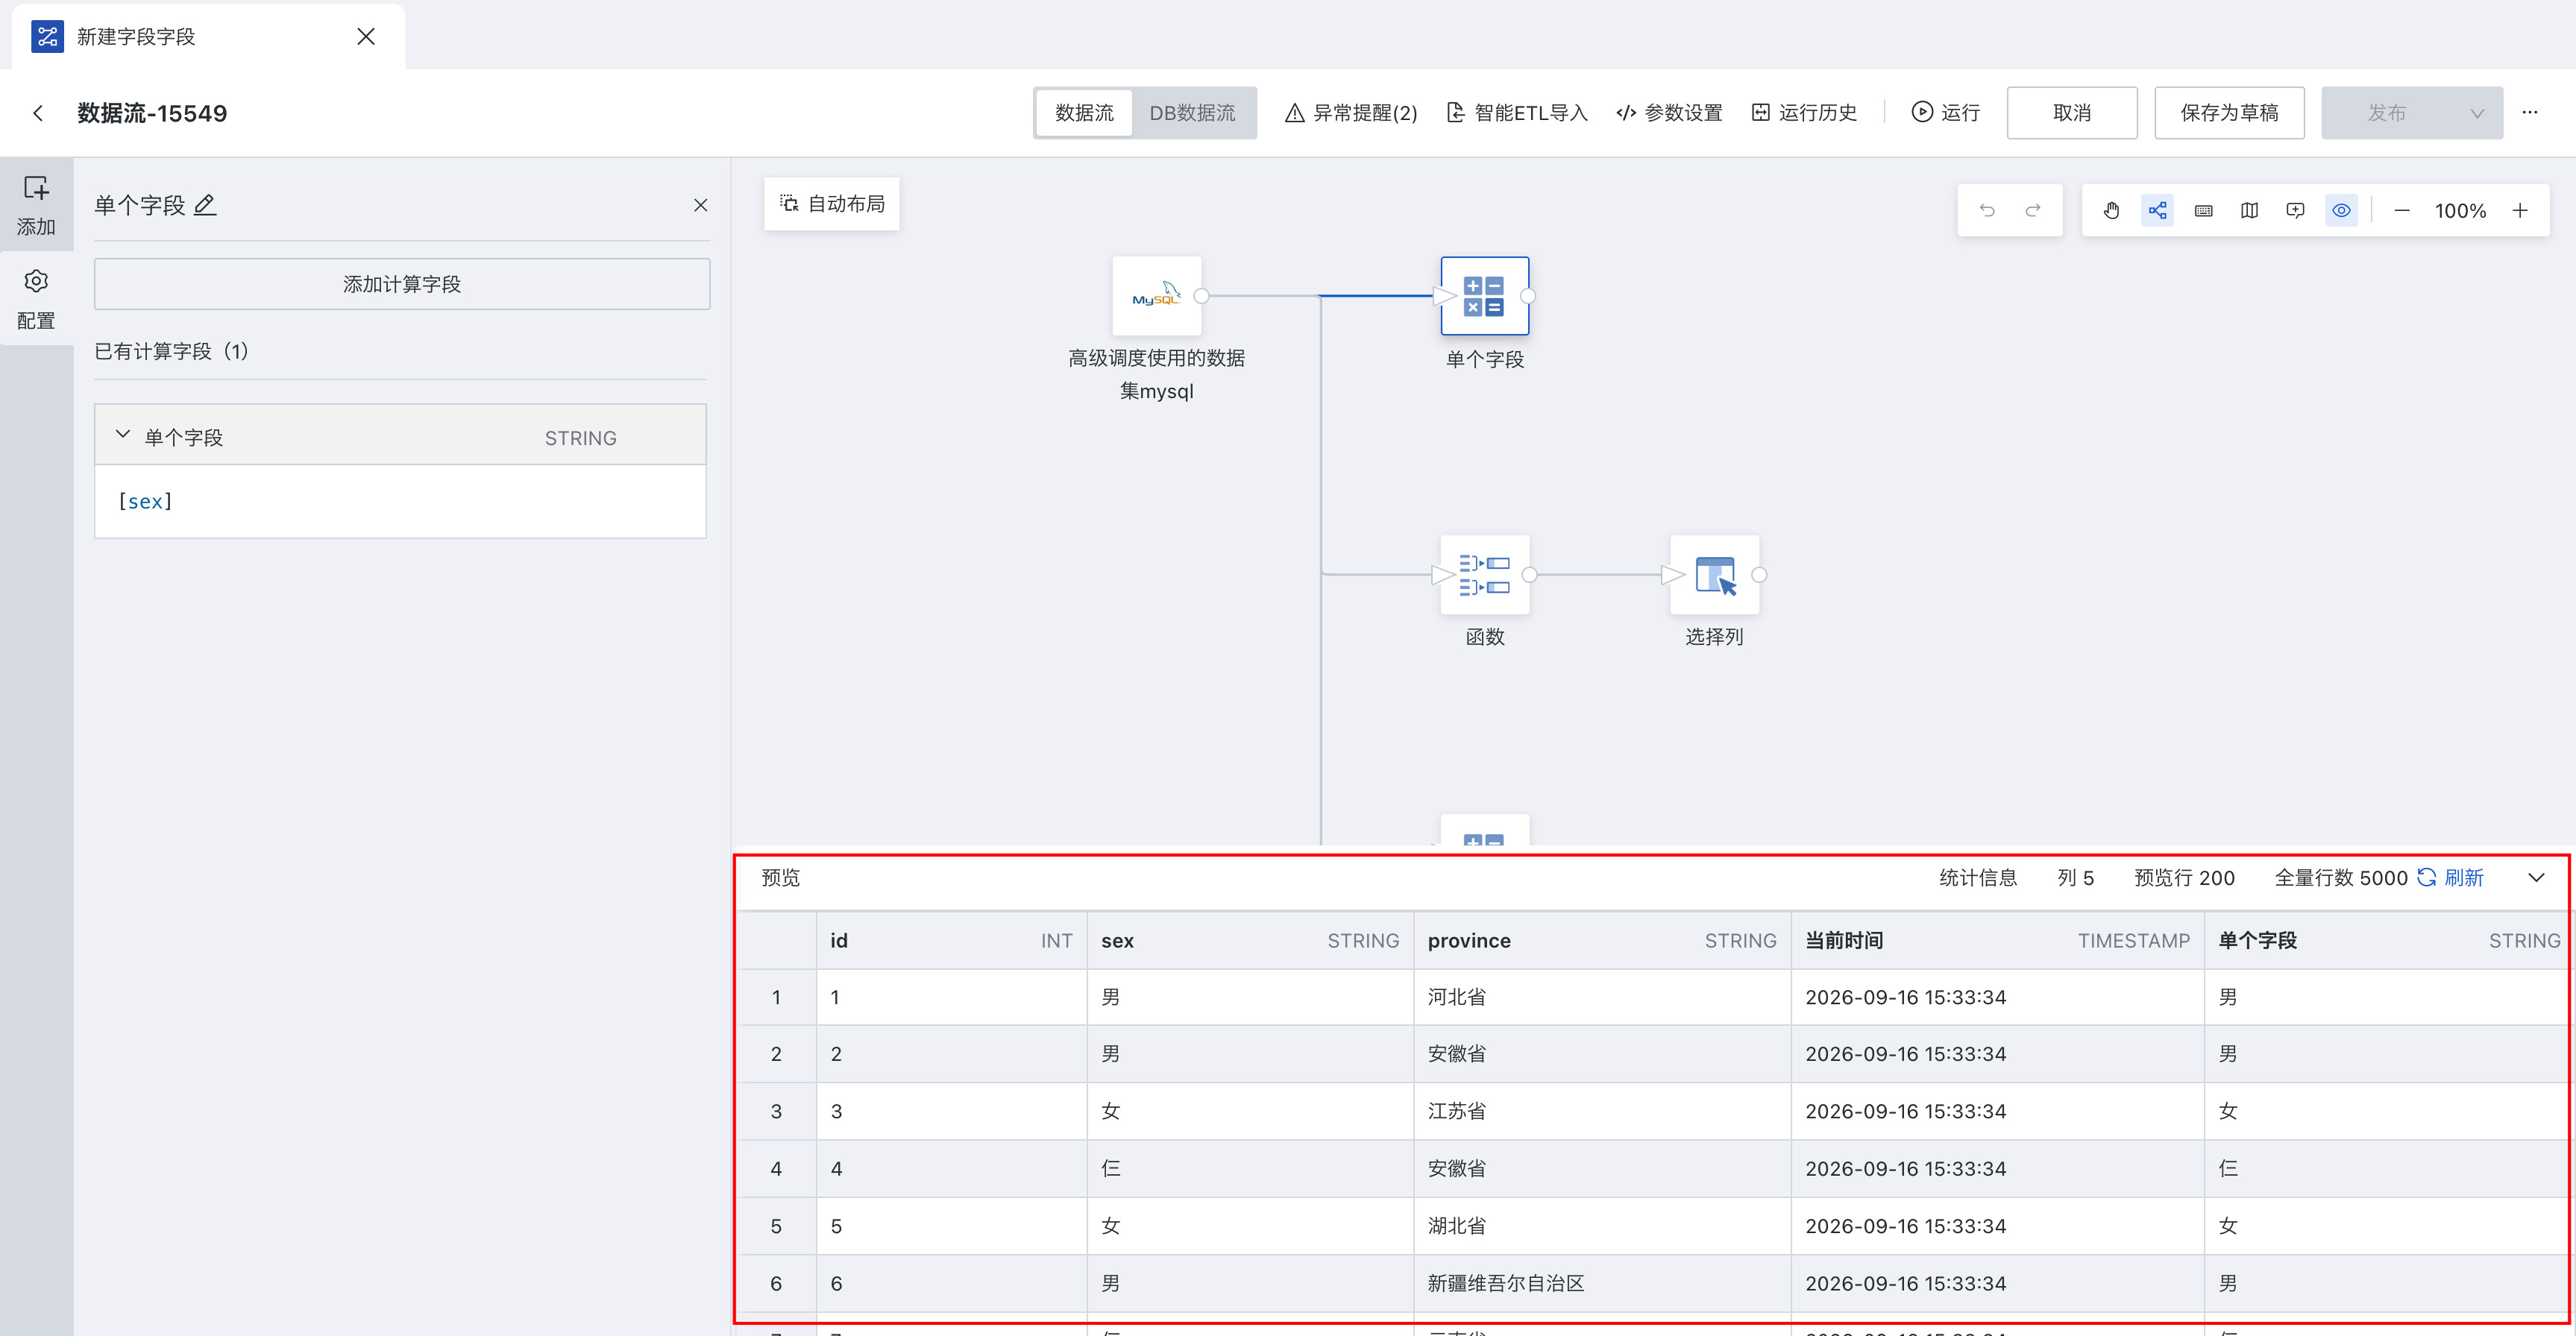
修改当前节点或上游节点的配置后,再次选中该节点并点击「预览」,即可按最新配置重新生成预览结果。
说明
预览仅用于快速检查数据处理结果,展示的是有限范围的数据,不代表正式运行的全部结果。正式运行数据流时,系统会按节点配置处理实际运行范围内的数据。
分析字段血缘
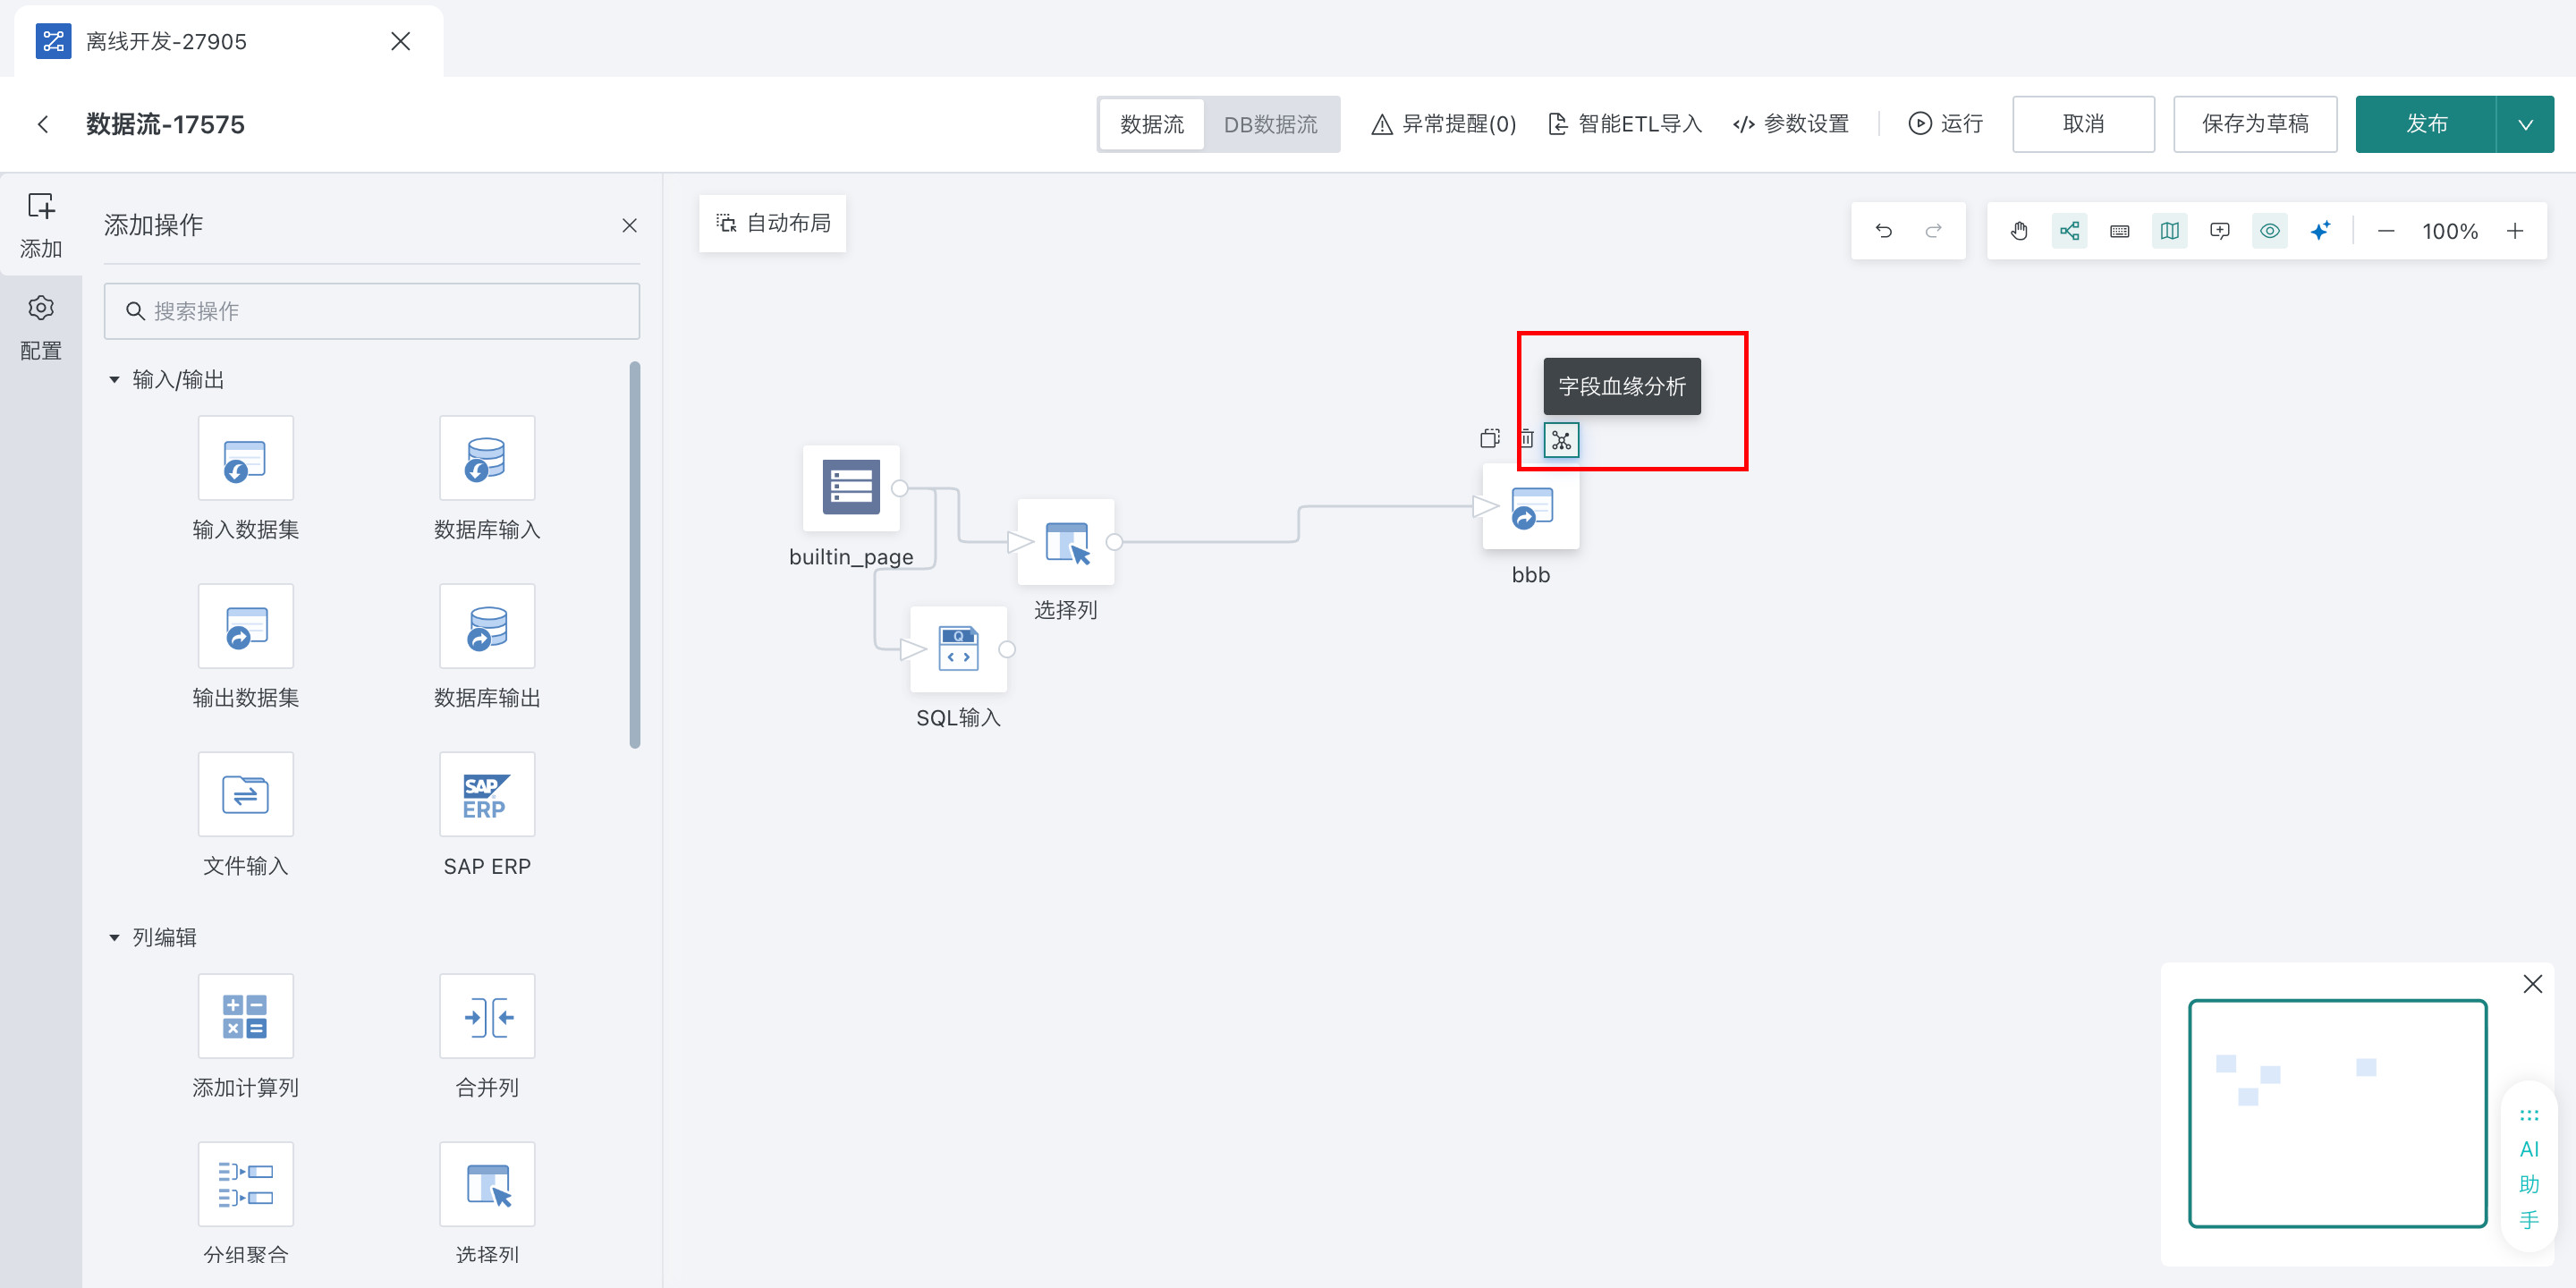
在任一算子上点击血缘图标,选择要分析的字段,即可查看该字段的上游算子。
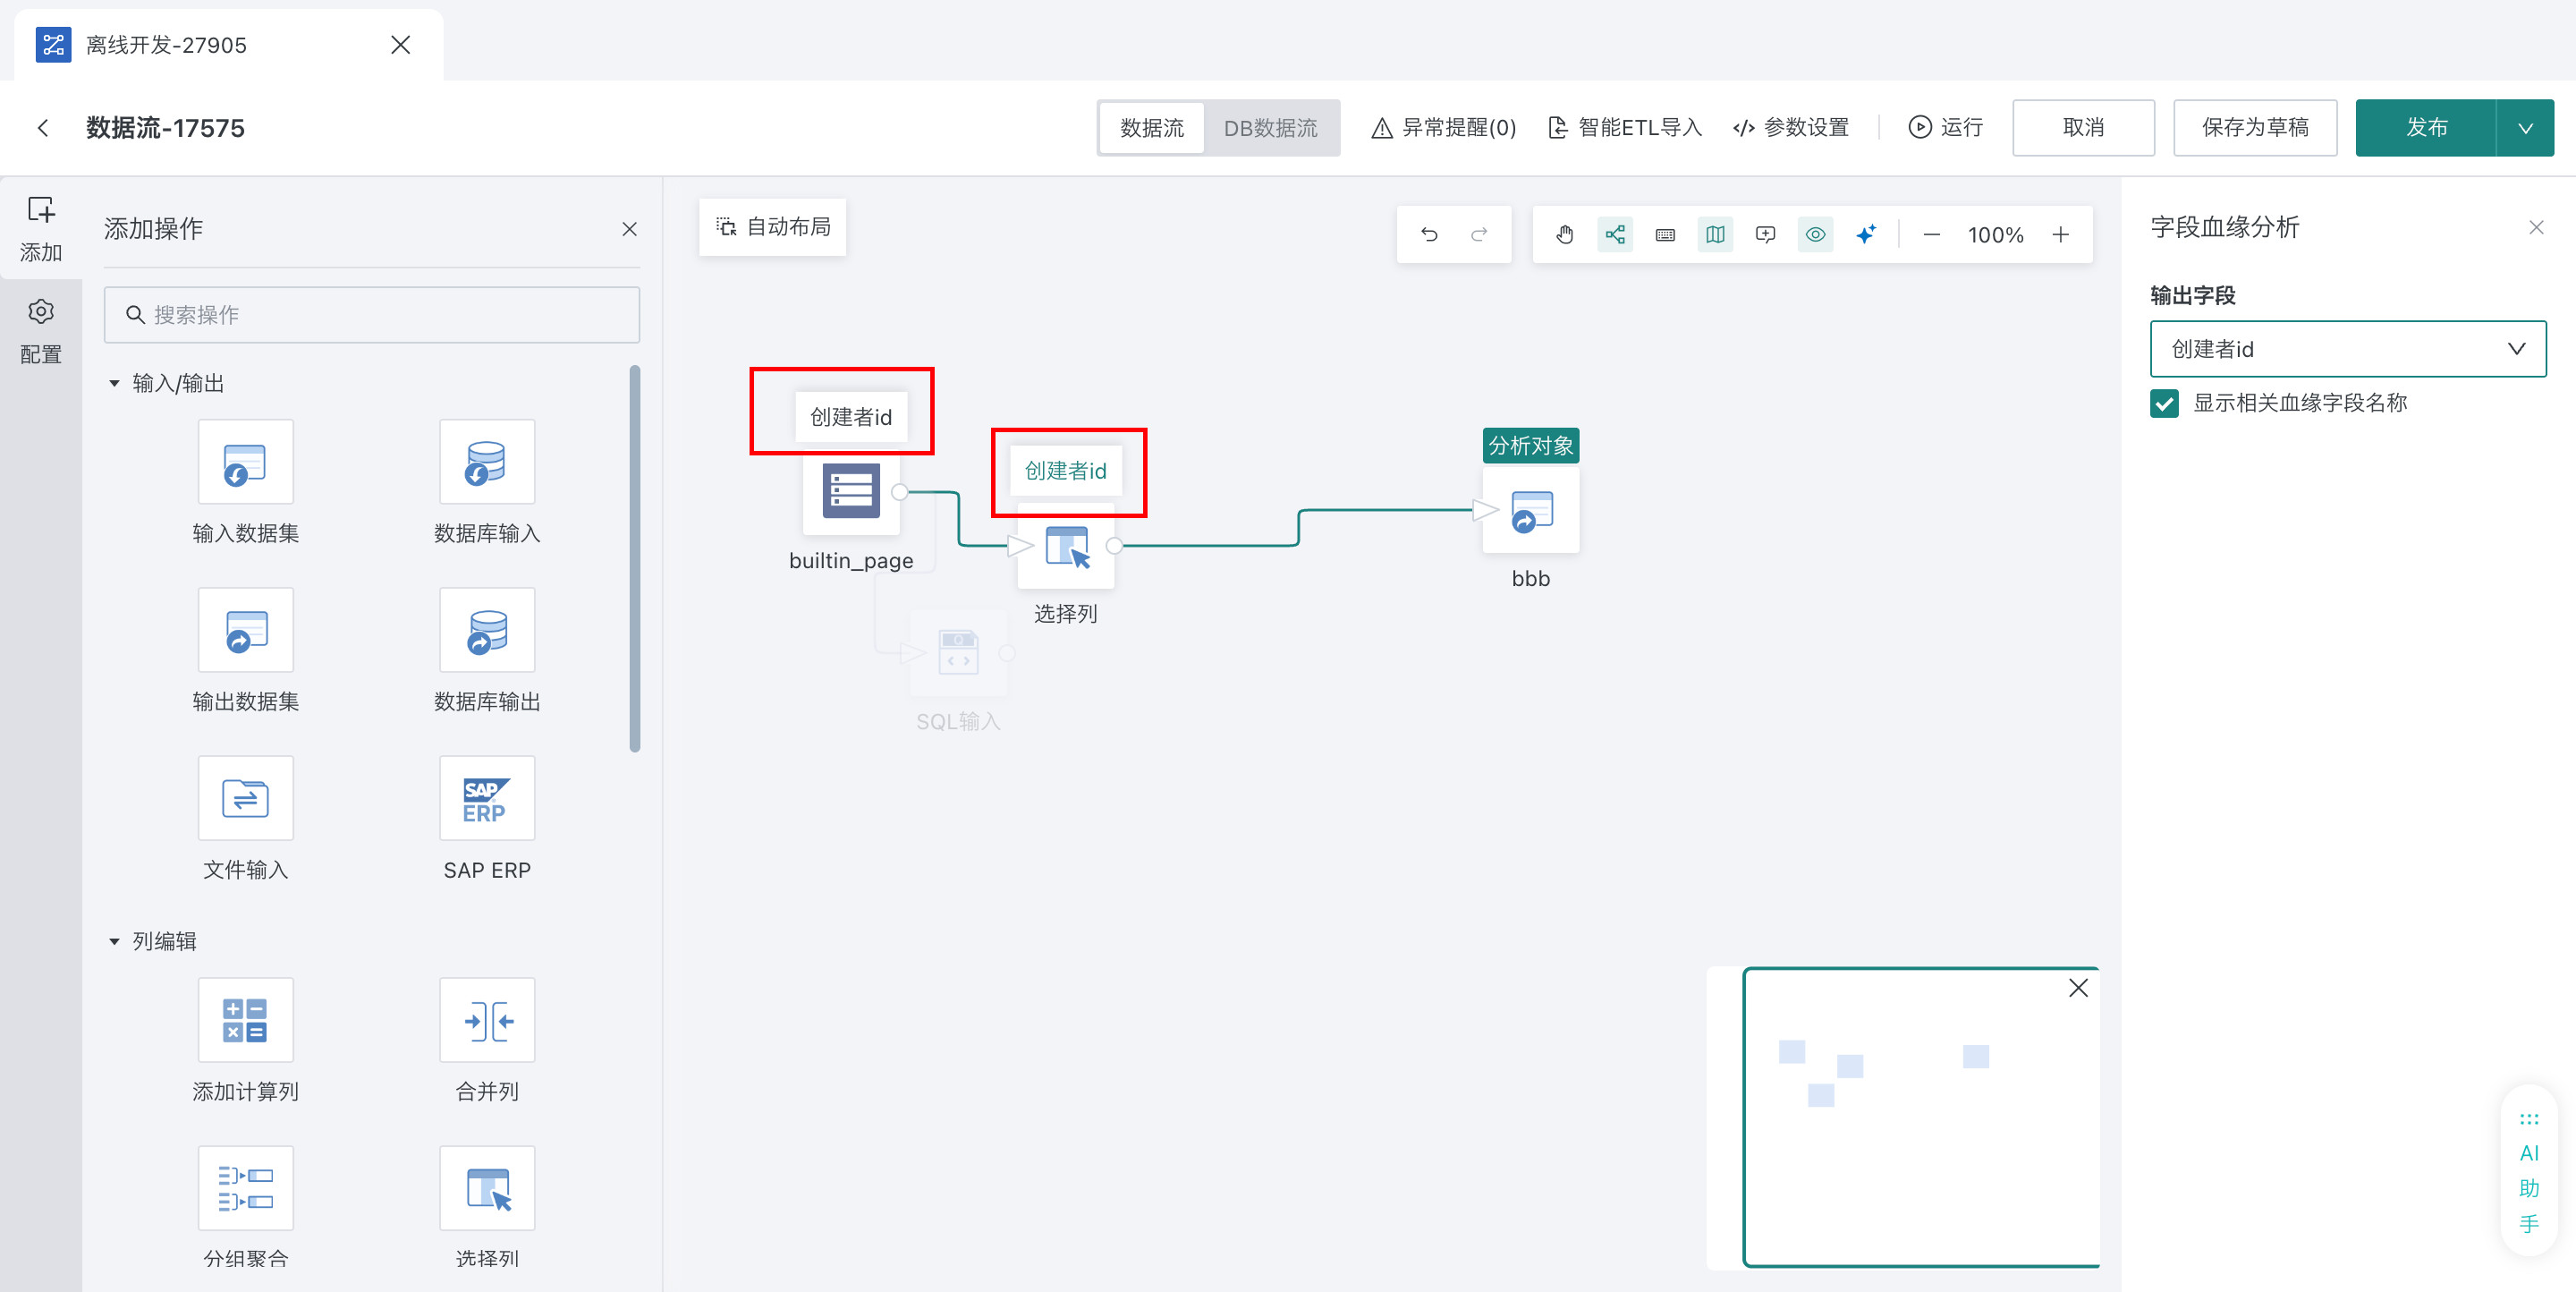
运行引擎
8.3 及以上版本默认使用 Gluten 引擎(Spark 升级版)运行数据流,以提升运行性能。
具体说明
数据流节点包括以下具体算子,请按需参阅具体文档。
数据集算子
| 算子 | 说明文档 |
|---|---|
| 输入数据集 | 输入数据集 |
| 输出数据集 | 输出数据集 |
| 数据库输入(高级版) | 数据库输入(高级版) |
| 数据库输出(高级版) | 数据库输出(高级版) |
列编辑算子
| 算子 | 说明文档 |
|---|---|
| 添加计算列 | 添加计算列 |
| 合并列 | 合并列 |
| 分组聚合 | 分组聚合 |
| 选择列 | 选择列 |
| 行转列 | 行转列 |
| 列转行 | 列转行 |
数据编辑算子
| 算子 | 说明文档 |
|---|---|
| 筛选数据行 | 筛选数据行 |
| 去重 | 去重 |
| 值替换 | 值替换 |
| Null 值替换 | Null值替换 |
数据集组合
| 算子 | 说明文档 |
|---|---|
| 行拼接 | 行拼接 |
| 关联数据 | 关联数据 |
高级计算
SQL 算子:SQL输入